标签

2015年2月11日星期三

关于决策树的更多——CART

上篇讲了ID3的后继C4.5,这篇讲讲有略大不同的(Classification and Regreession Tree,分类回归树)。它的特点是二分递归,产生真正的二叉树(这才是真正的Dichotomiser.。。。。=-=),也就是说无论是连续属性还是有两个值以上的离散属性,CART都只会把它们分成两个分支。

基尼指数
CART不使用熵的思路来衡量属性划分度量,而是使用了基尼指数(Gini Index)。一开始以为这是从经济学上拿来利用的概念,后来看来大概只是两者来自同一思路。维基百科上对CART的这一种度量称为基尼不纯度(Gini Impurity)。
经济学上,基尼系数用来衡量地区的收入不平等程度。在CART中它用来衡量训练集在某属性上的不纯度,定义:
划分连续属性称为二值属性的方法在讲C4.5时已经说过,这里只说如何划分离散属性。对于一个离散属性A,假设其值域为集合, 其幂集包含了它的所有子集。不考虑空集和其本身的情况,一共有个子集,又因为划分时,知道其中一个子集,另一个就是它的补集,划分方案有个,枚举划分方案有随集合大小指数增长的复杂度。
对于枚举出的对离散或是连续值的划分方案,我们计算其基尼系数:
我们选择基尼系数最小的划分方案来将非二值属性二值化,然后通过比较基尼系数,选择最小基尼系数的属性,也即分化程度最小的属性。

选用熵和基尼系数有何不同,我想这样一幅图能给出答案:

两者都在二值属性均分的时候达到最大值,但它们逼近最大值的速度变化不同,但在应用上有何区别上不得知。

代价复杂度
在剪枝问题上CART也是不同的,CART后剪枝使用的是代价复杂度(Cost Complexity)这一概念,对于一棵子树,其代价复杂度是这棵子树的错误率和叶子节点数的函数,有时表示成。类似悲观错误率,比较剪枝前后的代价复杂度,若复杂度变小,则剪去子树。剪枝的方法是自底向上对内部节点进行判断。

决策树的局限
前剪枝和后剪枝的结合使用能减少过拟合的现象,但在数据量大时还是难免防止树过大的情况,我们经常能遇到重复或是复制的问题。
重复(Repetition)即是从根节点开始的一条路径中,连续出现好几个对同一属性进行判断的节点。比如连续属性A的选择度量很大,那么我们经过第一次分裂分成了两个区间后,很有可能接下来的属性选择仍然选择的是A。
复制(Replication)是书中存在重复的子树,例如根据属性A划出两个子树,这两个子树又都按照B属性划分,便有了一毛一样的两个分支。
上面的两种情况在作业中也的确遇到了,也就是我们还没引入熵阈值的时候,树的深度不堪入目,那么可想而知更大的数据集这类问题大概更严重。
CART的一个解决办法是考虑多元划分,基于属性元组,而不是单个属性来划分,相当于构造出了新的属性。虽然教材上没提到,但我想到的一个思路是先将属性用类似机器学习中主成份分析(PCA,Principal Component Analysis,这个算法也是通过美赛第一天想思路时知道的)的方法,将多维的向量在不大量减少其信息值的前提下降维。
教材中提到的另一决策树局限是当数据集大到无法由内存装载的情况,如果只能从存储中分页读取训练集,那么我们无法同时掌握整体数据集的信息。两个思路能帮助解决,一是离散化连续属性,从而减少编码的空间,而是对数据进行抽样,而不利用全部的数据,当然,这就涉及到了抽样的代表性。这两个思路都很容易想到。还有诸如雨林(Rainforest)和树构造自助乐观(BOAT)等更厉害的算法,不过也是to be study了。

分类作为一个经典问题不止决策树一种方法,下一个想看的是贝叶斯分类。

关于决策树的更多——C4.5

在写前面关于AI作业的决策树笔记的时候接触了CART及C4.5两个决策树算法的名称,最近在《数据挖掘》这本教材上看到了它们的介绍。今年的ICM D题也让我更多地了解了数据挖掘中分类(Classification)和聚类(Clustering)的知识,虽然我们队最后没用上决策树的算法
数据挖掘中的分类和聚类的区别可以大体概括为有监督(Superised)学习和无监督(Unsuperised)学习的区别。虽然它们都是对数据进行划分(partition)的算法,但分类在学习阶段(也就是接受训练集训练)的时候,其数据库是包含了类标号(class label)的,用以指定某一条数据记录属于哪一个分类,而聚类的数据是不包括类标号的。好比前篇中的例子,用于训练判断党派的模型的原始数据中,包含了每一个议员的实际所属党,我们根据这些来得到我们要的模型。但若过原始数据中并不包括每个议员的党派,而只是他们在各个议题上的取态,我们要根据这些数据来为他们分类,这就是个聚类问题。说到这里的确有打算试一下在数据集上试一下聚类。【题外话,最近看美剧《新闻编辑室》,对美国的党派之争有了点兴趣】
前篇已经写过决策树算法的总体算法,不同的决策树算法实际是对总体思路的不断改进,因此不再冗述通用的过程。

信息增益率
ID3,C4.5和CART使用的均是贪心,不回溯的方法。C4.5作为ID3之后继,在选择属性的时候使用的度量标准是信息的增益率而非信息增益。其定义如下:

代表的是数据集D根据属性A进行划分后的“分裂信息(Split Information)”,与ID3的信息增益不同的是,它考虑该输出的元组数相对D中元组总数的比例。
为什么需要引入这个?细心的人会发现,基于信息增益的选择时,我们会倾向于选择那些具有大量可能值的属性,比如说数据库中每条记录有其唯一的ID,若数据集中包含着ID这一属性,根据ID划分,我们能得到N(N为数据记录数)个分支,其中分出来的每个子节点只包含该ID对应的那条记录,数据集大小为1,其信息纯度为最高。根据公式,有:
id这一属性的增益值是最大的可能值。之所以根据id划分的Remainder值会为0,是因为根据id划分出来的每个数据集都有最高的集中度(纯度),但实际上这样的划分显然很无意义。增益率中对增益的归一便能解决这一问题。GainRate计算的便是属性A的信息增益和分裂信息量的比。

悲观剪枝
What's more difference? C4.5的另一大不同是其剪枝方式。
之前作业中引入的减少过拟合的剪枝方法,若数据的增益小于某个阈值视为划分停止,取其大多数值结束划分,这其实是一种前剪枝(Prepruning)。后剪枝(Postpruning)则是在整棵原始树构建出来后,在根据算法砍去其冗余枝,而不是在构建时根据算法避免冗余枝产生。
C4.5的悲观剪枝(Pessimistic Pruning)利用对一棵子树的错误率评估来判断要不要把该子树砍除。因为原始错误率是用训练集的测试结果,既然树是训练集训练出的,其错误率往往很小,因此估算时使用了悲观的方法。
设子树有S个叶子节点(决策节点),划分到这一子树的有N个测试集样例,其中错误的例子共有E个,则其乐观错误率为。根据概率论中用正态分布拟合二项分布,p的置信区间为,我们的悲观错误率便是这一区间的上界,的取值可以是0.25。
当计算得剪枝后的错误率比剪枝前低的时候,我们就用子树的叶子节点中的多数值替换整棵子树。

连续值属性
如何划分那些连续值的属性,如果将数据集中的连续值属性看作是离散值,那也将是一场灾难,因为有多少个值就会划出多少个分支。很自然我们会想到,如果要划分连续值A,其决策过程应该是这样的:
也就是我们选择一个分裂点去对连续值进行二元划分。C4.5对连续属性的处理正是基于此。假设某节点的数据集中,连续属性A的所有取值排序后为, 任意相邻的一对值的中点均有可能成为分裂点。v个值将有v-1个划分方案。 我们对于每个划分方案,计算其Remainder,则Remainder最小的是我们需要的分裂方案(还是那句,因为这样分裂两边的集中度最高)。按照分裂点分成两个区间后,连续值的问题便成为了二值问题,我们便可将这个二值化后的属性与其他属性进行比较,从而确定要拿来划分的属性。

最后一句话,这篇东西应该加“机器学习”标签还是“数据挖掘”。。。。=-=

2015年2月9日星期一

《如何表达不同意》

说来有趣的是对于Paul Graham的博客,最开始打算翻译的是他的Lies We Tell Kids,这是一篇略长的杂文。拖延症导致至今还没译到一半。后来在编程随想君(BTW这是一个很好的博客)的一篇博文中看到这幅插图,看到Paul Graham的名字,从而发现了这篇讲思辨的短文。
小有知名度的反驳级别金字塔,译者不详

翻译短文工作量小比较有吸引力,因此我就先译了这篇小有知名度的。这篇文的最重要特点是Paul Graham提出了表达反对意见的水平评估方法。喷子哪个国度都有,他写此文大概也是看到了美国网民中的喷子。
原文名How to Disagree发在译文网后,这篇文的反响挺热烈的,在我的预料范围内(至少比奥威尔的文能引起网民兴趣,泪目)。精选之余译言还推送到了公众号和微博。
译文:


网络把写作变成了一种对话。二十年前,作者写,读者读。网络使得读者可以回复,事实上越来越多的人会在话题,论坛,或是他们自己发布的博客上评论。很多人回复某些事情都是在表达反对意见。这在预料中。同意往往没有不同意那么能使一个人活跃起来。而且当你同意的时候可以说的话更少。你可以在作者的言论基础上增加一些东西,但作者往往可能已经在最有可能引起兴趣的方面展开了。当你不同意的时候,你便可能进入了他还没有展开的方面。
结果是表达反对的评论越来越多,特别是从词汇量来说的话。这并不意味着人们变得更暴戾。我们交流方式的结构性改变就已经足已解释了。但尽管并不是因为愤怒导致了表达反对的增加,表达反对的增多会使人更容易愤怒仍是一个潜在的危险。尤其是在线上的情况,因那些不敢当面说的话在网上能更容易说出来。
如果我们都将更多地表达反对意见,我们就应该谨慎地表达。什么是恰当地表达反对?大多数读者都能够辨别单纯的辱骂和具有严谨推理的反驳,但我认为,给在这两者之间的各级别辩论归类命名,也能帮助我们认识。以下我试着给出一个表达反对的级别分法:

反驳级别0.辱骂 这是最低级的反驳,也可能是最常见得。我们都见过类似这样的评论:
你个基佬!!!!!!!!!!
意识到婉转地辱骂其实也只是轻了那么一点也是很重要的,一条像
PO主就是个自以为是的外行而已
的评论其实真的和狂妄式的“你个基佬”没多大差。

反驳级别1.诉诸人身
诉诸人身的攻击并不如辱骂那么没分量,可能还是有一定作用的。比如如果有个参议员写了篇文章,主张参议员的工资应该上涨,可能会有人这样回应:
他当然这么说了,他可是参议员啊。
这并不能驳倒作者的观点,但至少还是沾了点边的。尽管这仍是一种很无力的反驳形式。如果参议员的观点有错误,你应该指出是哪里错了;如果没有错,他是参议员会给正误带来什么改变吗?
说作者在某某话题没有权威,是诉诸人身的另一种形式——并且是特别无用的一种,因为好的思想往往来自圈外人。重点在于作者的正确与否。如果缺乏权威令他出现了错误,指出错误的点。如果没有错的话,就不构成问题。

反驳级别2.反驳语气 
从下面的这一等级起,我们会开始看到针对言论而非作者本身的回应。这其中最低级别的便是对作者的语气进行反对,例如:
简直无法相信原PO竟用如此傲慢的态度看待智慧设计论。
尽管这与攻击作者相比更好了,但仍然是一种很弱的反驳。作者是否正确和他的语气如何相比重要得多。尤其,因为语气这东西是很难界定的。若某人在某个话题上有芥蒂,他就可能会被对其他读者来说中立的言论冒犯到。
所以如果你对某言论能作出的最差评论就是批评它的语调,你等于没说什么。是作者语调轻率但却正确吗?这起码比严肃却错误好。而如果作者哪里错了,指出来。

反驳级别3.反对 
这个阶段终于到了开始回应内容,而不再是针对是谁说或是怎么说。回应一个观点最低级的方法是简单地陈述相反的观点,而没有或几乎没有支持的根据。
这通常与反驳等级2的表述结合,如:
简直无法相信原PO竟用如此傲慢的态度看待智慧设计论。智慧设计论是合理的科学理论啊。
简单的反对有时候会起到一定作用。有时明确地陈述反面足以证明其正确性。但通常情况下,有证据支持才会帮助证明。

反驳级别4.抗辩 
级别4终于到了能令人信服的反对方式:抗辩。在这一形式之前的级别基本可以被无视,因为它们什么都无法证明。而抗辩有可能能证明一些东西。问题是很难说清确切是什么。
抗辩相当于反对加上论证(及/或)证据。当直接针对原论点本身的时候,能做到令人信服。但不幸的是抗辩通常都针对了和原论点有稍微不同的东西。两个在争辩的热火朝天的人往往事实上在争论两个不同的问题。有时甚至是互相同意,但因为都陷在了争吵中而没有意识到。
当你认为他们错过了问题核心的时候,针对与原文有稍微不同的论点进行争辩也是合理的。但当你这么做时应该明确地说明。

反驳等级5.驳斥 
最有说服力的反对方式是驳斥。这也是最难得的,因为它比较复杂。其实,反对级别的分类构成了一种金字塔,级别越高,你越难找到实例。
要驳斥某人你就得引用他们的话。你得找到确切证据。找出你认为错误的,你不同意的部分,然后解释为什么那是错的。如果你找不出你反对的具体原话,你就是在进行稻草人论证。
虽然驳斥常需要引用原话,但引用了并不意味着驳斥。一些作者会引用若干他们认为错误的部分来制造合理驳斥的假象,然后发表和等级3乃至等级0一样的低级回应。

反驳等级6.驳斥中心观点 
驳斥的力度取决于你驳斥的对象。最有力的反对形式就是驳斥对方的中心观点。
即使到了级别5,我们仍时不时见到反对者耍花招,挑出论点中不重要的方面来驳斥。有时他们只是变成了一种看上去复杂化了的诉诸人身,而不是真的驳斥。例如纠正对方的语法,或是对名字和数字的错误喋喋不休。除非反对观点真的取决于这些细节,否则你纠正它们的目的只是使对手难堪。
真正的驳斥需要驳斥其中心论点,或至少是中心之一。这意味着需要明确指出对方的中心论点是什么。所以真正有效地驳斥应该是:
作者的主要观点大概是x。正如他所言:<引用原文>
但这是错误的,原因如下……
你指出错误的原文引用不一定要是作者主要观点。反驳其观点的根据就够了。

意义何在 
有了对反对意见的分类形式,有什么好处呢?反对层次的划分无法给到我们的其中之一是挑选赢者的方法。反对层次的划分只是描述了观点的形式,而不是其正误。一条级别6的回应仍可能是完全错误的。
但尽管这种层次划分无法给出一条回应的可信度下界,却能给出他的上界。一个级别6的回应可能无法令人信服,但一个级别2乃至更低的回应总是无法令人信服的。
对反对言论的形式进行分类其中一个最重要的好处是可以帮助人们评估自己所阅读的内容。特别是帮助到人们看出理智不诚实的论调。一个雄辩的演讲者或是作者有办法通过仅仅使用有力的言辞来制造打败对手的假象。事实上这种技能可能是一个煽动家的决定性能力。通过为不同形式的反对论点命名,我们就为有批判性思维的读者提供了一根戳穿这些气球的针。
这种标签也能帮助到写作者。大部分的理智不诚实都是无意识的。一个在反驳语气的人可能真的觉得他所说的并不是废话。而通过拉近观察,审视他自己在反对级别中的位置,可能能帮助他朝着抗辩或驳斥的级别改进。
但恰当地反对的最大好处不在于它能令对话改进,而是另被反对的人能更高兴。如果你研究对话,你会发现级别1的对话比级别6会有更多刻薄在其中。而当你真的想表达点什么的时候,根本没有必要表现得刻薄。事实上,你不想如此。当你真的要表达的时候,表现刻薄反而只会成为障碍。
如果从分类级别越往上可以令人们少些刻薄言辞,便会令人们更愉悦。大部分人并不喜欢表现刻薄,他们只是不自觉地这么做。
感谢Trevor Blackwell和Jessica Livingston检查了本文的草稿。

题外话,关于要不要把译文放到自己的博客。一开始注册译言账号的时候,其实就是为了发自己翻译的奥威尔的文,译了《就在鼻子前》和《你与原子弹》两篇,后来发现可以译的有趣的文其实挺多的,又想到也要译Paul Graham的博文。至于要不要把译文放到这里来,还是看重要程度吧。
维基百科上有一系列的逻辑谬误词条,足以作为本文的延伸。

2014年12月28日星期日

MD5算法笔记

MD5(Message-Digest Algorithm 5,消息摘要算法第五版),是广泛使用的哈希算法之一,主流编程语言普遍已有MD5的实现。第一次接触是在写项目的时候,直接用PHP中的现有函数来加密一些信息。Web安全选修课中的一个作业是要实现这个算法,这里记录一下学习的笔记。
MD5的输入是一条不定长度的信息,输出一条固定长度128位的信息,也即生成四个32位数据。基本方式为,求余、取余、调整长度、与链接变量进行循环运算。
例如英语中的经典句子“The quick brown fox jumps over the lazy dog”,经过加密后,
MD5("The quick brown fox jumps over the lazy dog") = 9e107d9d372bb6826bd81d3542a419d6

算法过程
预处理,假设我们要加密的信息长度为B 字节,即一共为b = 8B位。
根据MD5的填充原则,我们需要补上1个1和n个0,令总位数除512的时候余448。
可以推出,经过第一步填补后的位数仍为8的位数,因此补上一个1后必定至少补七个0,相当于补上0x80.
然后我们一直在后面补上0x00,直到总位数除512时余448。
之所以要让余数刚好为448,是因为我们需要在后面补上用64位表示的原信息长度,448+64 = 512,恰好能让信息位数为512的倍数。
原信息长度为8B bit,我们将8B这个数字用2进制64位表示出来,然后通过小段规则(低字节在前)补到信息的末尾。
这样一来,我们有了一组增补后长度为512N的信息。
增补后的信息可以分为N个512位(64字节)的块,可以分为16个4字节大小的组,每组32位。
我们定义4个幻数,0x674523010xefcdab890x98badcfe0x10325476,分别为A,B,C,D
以及4个非线性位操作函数
对每一块进行操作,接下来的64次循环,每16次都会用到其中一个函数。
对于每一个64字节的块,我们都算出其非线性函数的值,然后与A,该轮对应分组,以及一个数组K的对应值相加,然后进行一定的逻辑循环移位。
K数组大小为64,产生过程K数组的过程是:遍历这个数组,求出当前下标的sin绝对值与2的32次幂的乘积,再取整。
每次循环后,我们将A,B,C,D的值循环交换,即A的值赋给D,B的值赋给A,如此循环左推。对于每个64字节块都进行一次这样的操作,完成后A,B,C,D的值即我们加密后的信息,注意的是我们需要小端格式的输出。

源代码
Github链接

算法应用
接触种子下载的用户会注意到,BT软件会通过计算MD5检验下载到的文件片段的完整性。MD5作为一个哈希算法不可能没有碰撞。2009年,谢涛和冯登国破解了MD5的碰撞抵抗,该攻击在普通计算机上运行只需要数秒钟。因为这一碰撞风险,用户的密码加密算法不应采取MD5。改进MD5的方式可以是,在加密前,字符串加上一组随机字符串,只有双方才掌握这一随机串,这种方法可以防止通过碰撞来获得加密的内容。网上我们能搜到的MD5解密算法,原理便是通过对大量已有的字符串进行加密获得加密后的串,当用户需要解密的时候,才在其中寻找其原串。


SOJ 1153 马的周游问题

题目描述
国际象棋棋盘中,马/骑士(Knight)行日字型,和中国象棋一样。给定一个马的起点位置,我们要求出马把棋盘中所有位置周游一遍并且不会出现重复的路线
对这样一个8 * 8的棋盘编号如下:
01 02 03 04 05 06 07 08
09 10 11 12 13 14 15 16
17 18 19 20 21 22 23 24
25 26 27 28 29 30 31 32
33 34 35 36 37 38 39 40
41 42 43 44 45 46 47 48
49 50 51 52 53 54 55 56
57 58 59 60 61 62 63 64

从维基上盗个

算法思想及解题用到的主要数据结构
本题中我们将会用到深度优先搜索+回溯的算法。对于马棋子的当前位置,我们找出它能够往下走的下一位置,从中选择一个位置走,当马无法找到新的可行位置,而问题又未解决(即棋盘未被周游)时,我们让它回溯到前一个状态,说明前一个选择的位置是一条死路。我们继续选择可行的位置,直到没有新的可行位置,我们回溯到前一状态。
在一个假设不限大小,所有位置都合法的棋盘,一个马棋子能够走八个方向,也即有八个可选的位置。对于一个马的位置状态,我们求解出所有这八个位置,然后通过合法性判断剔除出超出8x8范围的位置。同时,由于周游要求所有的位置只被寻访一次,我们建立一个布尔型数组记录已被寻访过的位置,并在每次选择前先将已被寻访的位置剔除。(一个8x8大小的布尔矩阵是64字节,我们可以用一个double类型的8字节(64位)来表示,通过位操作来改变这个记录)。但由于题目的棋盘范围为8x8,盲目地选择位置搜索仍然会带来不必要的时间耗损。

逐步求精算法描述
一条成功周游的路线,我们在找寻时假设有N个合法的next位置,我们假设所有的next位置会导向死路的概率相同,我们倾向于先搜索可行路径更少的节点,这样就能够及早地发现死路及早回溯。


如图,若在选择next节点前,我们先根据next节点的next节点个数进行升序排序,在通常情况下能够避免在找寻中在错误的路径中耗费太多时间,同时,一条可行的路径在搜索过程中,next节点的个数应该是越来越少的。
我们在position这个数据结构中添加一个变量potential记录这个位置的合法next位置的数目,在选择下一节点前,先通过排序,选择potential更小的节点进行访问。
上面的这个优化思路是可行的。为什么?
维基百科告诉我们,马的周游问题其实就是一个古老的图问题----哈密尔顿路径的一种形式.题目要求寻找的是一条“开路径”(遍历所有位置后不需要回到初始位置)。Cull和Conrad证明了对于任何一个m×nmnm5)棋盘,至少有一个(可能是开路径)的马周游路径。
上面我简单用图表示的现象,十分没有说服力,因为我也没办法确定这样一定正确。事实上,这个想法和Warnsdorff规则不谋而合。
Warnsdorff在1823年提出了一个启发性的贪心算法,我们称为Warnsdorff规则,指在所有可走且未经过的方格中,马只可能走这样一个方格:从该方格出发,马能跳的方格数最少;如果可跳的方格数相等,则从当前位置看,方格序号小的优先。依照这一规则往往可以找到一条路径但是并不一定能够成功。换言之,在进行深搜时优先拓展拥有最少下一步可能移动位置的子节点。
此外,Warnsdorff 算法还有两个改进版本 W+和 W2,但在8 × 8这样小规模的棋盘上
优化效果并不明显。这个问题可以通过分治法和神经网络来解决。

Further Read:Knight's tour - Wikipedia 下面的参考文献

SOJ 1151 魔板

题目描述
SOJ 1151是一道关于搜索的题目,魔板由八个方块组成,为一个2×4的矩阵,每块分别用1-8表示颜色区别,每一次均可以对其进行一次操作,其中可选操作为A,B,C:
A操作(上下行互换)
B操作(每次以行循环右移一个)
C操作(中间四小块顺时针转一格)
魔板初始状态为
1 2 3 4
8 7 6 5
给定一个目标状态,给定一个最大步数,要求求出从初态到目标态的最小操作序列,若超出最大步数则停止计算,输出-1

算法思想及解题用到的主要数据结构
由于本题的目标是尽快找到解,通过分析,我们可以知道从一个状态执行三种操作到达其下一个状态,在决策树中三个分支是代价一致的(即所有深度相同的节点代价相同),因此我们可以通过广度优先搜索搜寻解,其找到的解必定是最优解。
广度优先搜索的过程我们需要用到队列这种数据结构来辅助。
关于魔板的表示方式,我们可以使用字符串,定义一个结构体board,其中包括两个字符串status和op,status为一个表示此魔板状态的8长字符串,只有字符1-8,op表示初态转换为当前魔板状态的操作序列,由字符ABC组成,初态的op为空字符串。
同时,由于由1-8组成的8串只有8!=40320种不同情况,我们可以想办法记录已经搜索过的状况,确保没有重复搜索。
记录已经搜索状况的数据结构,需要用到关联数组。

详细解题思路
根据广搜的原理,我们首先将目标状态放入队列,对于维护队列的队头,我们先检查其符不符合目标状态,若不符合,我们获得它经过三种操作后的三种状态,放入队尾,然后把当前队头弹出队列。直到我们找到目标状态,或者操作的深度已经超过最大限度,循环结束。
同时为了方便判断重复状态,我们在将状态放入队列之前还需要将其记录下来,以map为例,我们在将下一状态放入队列前,先在map中搜索,判断其是否为已经搜索过的状态,若否,我们将该状态的<status, op>数据对放入用于判断的map中。

逐步求精算法描述
由于在map中搜索也需要一定的时间复杂度,为了避免不必要的搜索,我们可以在插入队列前先做一定的剪枝。
考虑如同XX……XX的一个操作序列/字符串,我们可以知道,一个状态连续进行两次A操作会变为它本身,一个不必搜索的状态,在计算三种操作能到达的状态前,我们可以先分析当前状态的op串的最后一个字符串,若为A,则我们不必搜寻其进行A操作后得到的下一个状态,达到剪枝的目的,并节省需要在map中搜索才得出结果的时间。
同理XX……X = XX……XBBBB,XX……X = XX……XCCCC,可以帮助剪枝。
当然,上面这个方法只是小儿科,当我们能将进行一次操作的复杂度降低时,便不需要上面的这个预分析的办法,下面讲讲两种优化技巧。

康托展开
康托展开是一个全排列到一个自然数的双射,常用于构建哈希表时的空间压缩。康托展开的实质是计算当前排列在所有由小到大全排列中的顺序,因此是可逆的。比如说题目中的这种情况,一个魔板状态相当于一个1到8的全排列状态,通过康托展开,我们可以用一个0 到 40319的数字表示8!种状态,又因为这是一个双射,很容易可以通过这个数字还原这个全排列。


位运算处理
模板状态的保存问题,我们看到题目,很自然会想到用一个2x4的字符矩阵来保存这个状态,又或者是一个大小为8的数组,所以储存一个状态占用8个字节。对于ABC三类操作,通过交换数组/矩阵内的元素位置实现。这里引入位运算的办法来简化这一过程。
8个1-8的十进制数,用二进制表示,每个数至少要4位,一共需要32位(四字节),即一个int类型的大小。我们就用一个int类型内的二进制位表示一个魔板状态。
这样一来,对数组内的元素交换位置,可以改为速度更快的微操作:
A(x) = (x ≪ 16) | (x ≫ 16)
前16位表示第一行,后16位表示第二行,将x左移16位和右移16位的结果合并,则实现上下行的交换
B(x) = [(x &0xFFF0FFF0) ≫ 4] | [(x &0x000F000F) ≪ 12]
(x &0x000F000F),取出魔板的最右一列,左移12位变为左数第一列,将其余的三列((x &0xFFF0FFF0))右移4位,表示循环右移的结果
C(x) = (x &0xF00FF00F) | [(x &0x0F000000) ≫ 4] | [(x &0x00F00000) ≫ 16]
| [(x &0x00000F00) ≪ 16] | [(x &0x000000F0) ≪ 4]
相当于初始状态中2-3-6-7循环交换位置。
这一做法是一个同学的启发,他用位操作用得非常巧妙,经常受他启发。当然很多时候很多问题用位操作都可以加速,只是思考编码的过程如果不熟练的话需要更多的时间。

总结
N为状态总数,在预处理时,广度优先需要访问每个状态,对于每个状态需要O(log N)的时间复杂度。将其插入到关联数组中。在回答输入的查询时,对于每个查询需要O(log N)的时间复杂度来得到关联数组中的元素。假设一共有M个查询,则该算法的时间复杂度为O(Nlog N + Mlog N) = O((N + M) log N)

简单地说,我们求精的思路过程是:
简单的广搜,没有记忆化(会有很多重复状态)->加入记忆化,记录已经走过的状态(判断一个状态有没有走过也需要时间)->剪枝,通过查看操作序列判断是否应该执行某操作,因若进行该操作,得到的状态必然为已经走过的(判断这个也需要时间)->把所有可能先搜出来并记录,对于每条查询,直接在答案中找。

2014年12月11日星期四

ID3决策树算法笔记及一个简单应用

机器学习中的决策树训练,使用决策树作为预测模型来预测样本的类标。这种决策树也称作分类树(当属性为离散值)或回归树(当属性为连续值)。名词分类与回归树(Classification And Regression Tree,CART)指的便是这一统称。很自然我们可以想到,在更复杂的情况下,若属性的集合中既包括离散值的属性,也包括连续值的方向,两种树需要被结合。在这些树的结构里, 叶子节点给出的是最终的决策值,而从根节点到叶节点的过程,表示的是从一开始的整个决策属性选择过程。下面我通过人工智能课程作业的样例来对离散情况下的分类树算法进行简介。
例:给定一组美国国会的投票结果数据集,若根据一个人对各类议题的态度推断出其党派。需要通过划分用一部分数据训练出决策树。这棵决策树的准确率我们可以用另一部分数据进行准确度检验。
数据来源:1984 United States Congressional Voting Records Database
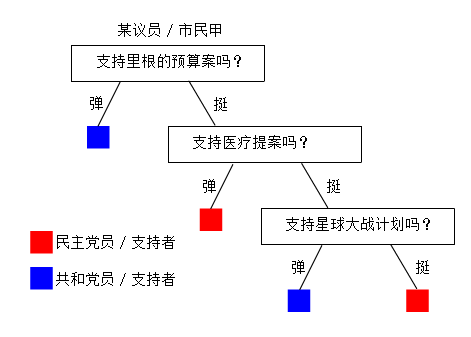
没了解过的人,大概也能看懂下面这幅图,在1984年美国某个社会调查小组也许会通过总结社调结果搞出类似这样一个东西,当然这个我是瞎掰的:


决策树便是利用一些统计学的知识,利用已有的信息,帮助对未知的信息进行决策。我们当然希望这样一个过程越短越好,越准确越好。

数据模型
将数据集的每条记录视作一个数据结构,训练集中,每一条记录都有其所属党派,可以分为共和党(下称Rep)或民主党(下称Dem)。数据中每一个议员都在十六个不同的议题上表态,我们将这十六个议题视作这条数据记录的十六个属性。在这个问题上,每个属性都有三个可能取值:Yes,No,Unknown,表示投票结果的三种可能。

评估模型
为了最小化决策树深度,我们需要每次尽量挑选能最好划分数据集的属性。理想情况下是能将样例分为只包括正或反例的子数据集。最糟糕的情况是划出的子数据集中正反例的数量比例一致。
为什么要这样做?简单画了这个示意图,我想可以说明选择属性的重要性。


民主党的人大概会更倾向于反对时任共和党总统里根的预算案,这是一个区分度高的议题,但援助尼加拉瓜反政府军这个问题很可能一个党内意见就未必那么统一(上面这图也是我瞎掰的,因为在数据中发现,即使是一些看上去区分度应该很低的议题,同一个党内的意见统一度也很高)。再举个离谱点的例子,对于一个中原人,他喜欢吃咸豆腐脑还是甜豆腐花,更多地可能可以用来判断他是南方人还是北方人,而不是他属于左派还是右派。也就是说,如果我们好的议题作为第一个划分的依据,很可能很快就结束整个决策树的建造。
我们引入一个函数I评估一组数据能提供的期望信息量。


当这组数据中正反两例的比例越接近的时候,函数的值越接近1,而数据的比例越悬殊,函数值越接近0。
对于一个特定属性A,我们评估选择其作为划分属性时所能获得的增益,需要函数:


其中对于属性A中的属性值a1,a2,…,an(在这个样例中为Yes,No,Unknown),我们需计算:


Remainder用于评估选择该属性后能获得的信息量,我们希望根据这个属性划分后的子数据集中,党派的分散程度越小越好(即能更快完成划分),因此我们计算根据此属性划分后其子数据集的信息量加权和。这个值越小,即说明划分后各子数据集的党派集中度越高。信息增益即为原始数据的信息量和划分后的信息量的差值。

算法分析
决策树的训练过程是通过对原始数据集的属性进行分类(归纳学习),在这个问题上我们讨论布尔分类,即只有正反两个值的离散函数。假定对于一个议员m,其所属党派是一个关于其在十六个议题上投票意向的布尔函数,我们需要根据训练集训练出如下函数,也就是类似第一张图展示的结果:

对于训练集中的所有记录,我们需要决定用哪个属性来进行树的训练。例如我们选择议题一(下称属性)作为划分标准后,便可以根据各条记录在这个属性上所取的值,将数据集划分为三组,将这些数据集分配给当前树节点的三个子节点,我们便可以递归地进行这个过程。一个决策树节点在递归过程中,在一定条件下成为叶子节点,即最终对应决策值的决策节点,此时递归停止。

算法流程
A.对于每个节点的训练过程,若该节点的数据集中同时存在Rep与Dem,我们继续选择一个属性,来对这个节点进行进一步划分;
B.若数据集中均为Rep或均为Dem,这个节点已可视为完成,可以根据数据集中剩余的是Rep还是Dem来决定这个节点的决策;
C.当一个节点被划分到一个没有任何实例的情况,其训练集为空时,说明在其父节点的数据集中,对于其父节点所选取的属性,并没有任何一条取了当前节点对应的属性值。这种情况我们同样需要视为完成,这个节点的决策缺省值应该由其父节点来决定;
D.由于决策树中,每一条从根节点到叶子节点(决策节点)的路径中,中间节点所选择的属性不能出现重复,当一条路径已经用完全部属性后,我们将面临噪声的问题。换言之,当前的训练集实例中,有完全相同的属性描述,但却取了不同的正反值(即有分属两党的议员在所有议题上的态度都吻合)。我们在这里选取的办法是取数据集中的大多数作为这个决策节点的决策值。

伪代码
function DECISION-TREE-LEARNING(examples, attributes, parent_examples) returns a tree

        if examples is empty //当前节点样例集若为空

                return PLURALITY-VALUE(parent_examples) //返回父节点的多数值

        else if examples have the same classification //样例集清一色相同

                return the classification //返回该分类值

        else if attributes is empty //已无属性可划分

                return PLURALITY-VALUE(examples) //返回样例的多数值

        else //需要递归建树

                A ß ArgMax(IMPORTANCE(a, examples)) //选出最佳属性

                tree ß a new decision tree with root test A

                for each value vk of A do //为子节点分配样例

                        exs ß {e : e ∈ examples and e.A = Vk}

                        subtree ß DECISION-TREE-LEARNING(exs,atrributes-A,examples)

                        add a branch to tree with label (A = Vk) and sub-tree subtree

                        return tree


算法优化
在有大规模属性集的情况下,在数据中寻找无意义的规律性,这种情况称为过拟合。  为了避免在训练过程中噪声的出现产生过拟合,我们需要尽量避免引入无关的属性(如  下图所示)。一种办法是改变终止递归的条件以实现剪枝。引入信息量函数后,我们可以在处理每个节点的时候先计算其训练集的信息量函数,若信息量小到不足以让我们对    其进行进一步划分(这种情况下,训练集中的正反例比例将非常不平衡,最极端的情况下,只有正例或只有反例时信息量为0),我们则不需要等到样例中只剩同一种样本,而是直接停止递归,用样本中的多数值作为此叶子节点的决策值。
我们需要做的便是,将伪代码中
else if attributes is empty //已无属性可划分
return PLURALITY-VALUE(examples) //返回样例的多数值
改为
else if the choosed best attribute’s I < threshold //属性的增益小于阈值
return PLURALITY-VALUE(examples) //返回样例的多数值
对于一个有噪声的数据集,这个方法很有用。阈值取什么是关键,我们通过多个阈值的十折交叉测试,发现一个有趣的现象,对于这个样例而言最佳的阈值有两段,而不是像想像中那样只有一个峰值。这个现象的原因未明。